Mamba-2는 왜 Transformer와 닮았는가: SSD로 다시 읽는 SSM

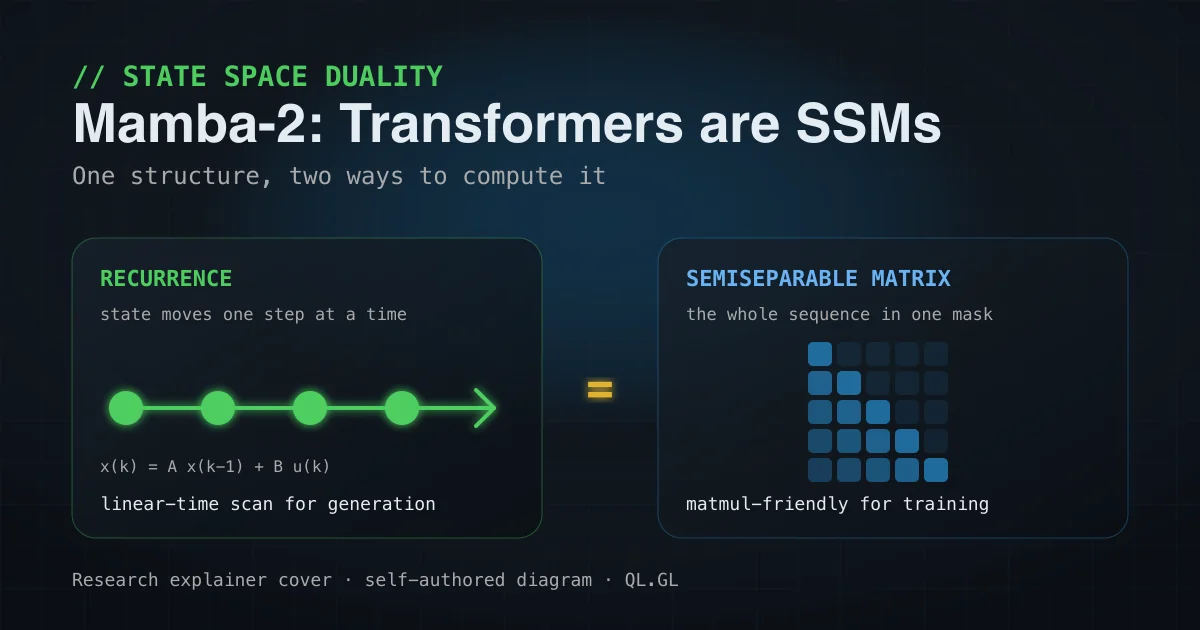
긴 문장을 다루는 모델의 병목은 단순히 파라미터 수가 아니다. 학습에서는 긴 시퀀스의 모든 위치를 병렬로 처리해야 하고, 생성에서는 매 토큰마다 과거 정보를 읽어야 한다. Transformer는 강력한 전역 어텐션을 얻는 대신 시퀀스 길이에 따른 계산과 메모리 부담을 감수한다. Mamba 계열의 상태공간모델(SSM)은 recurrent state를 유지해 생성 시 상태 크기를 고정하려 하지만, 학습과 GPU 활용을 Transformer만큼 쉽게 설명하기 어렵다.
Tri Dao와 Albert Gu의 논문은 이 둘을 경쟁하는 상자처럼 놓지 않는다. 핵심 질문은 “SSM과 어텐션을 같은 구조적 언어로 표현할 수 있는가”다. 논문은 구조적 준반분리 행렬(structured semiseparable matrix)을 매개로 두 계열의 관계를 정리하고, 그 관점에서 Mamba-2의 핵심 계층과 SSD 알고리즘을 제안한다. 아래 내용은 arXiv 원문과 HTML의 초록·방법·실험 서술에 근거하며, 재현 코드 실행 결과를 추가한 글이 아니다.
문제: 선형 복잡도만으로는 충분하지 않다
SSM의 전형적인 형태는 상태를 갱신하는 식으로 쓸 수 있다.
h_t = A_t h_{t-1} + B_t x_t
 y_t = C_t^T h_t
상태 h는 과거 입력을 압축한 작업 메모리다. 생성 시에는 전체 토큰을 다시 보지 않고 이 상태만 다음 단계로 넘길 수 있다. Mamba의 선택적(selective) SSM처럼 A, B, C가 입력에 따라 달라지면 어떤 정보가 유지되고 지워질지도 토큰별로 조절된다. 그러나 한 토큰씩 순서대로 갱신하는 계산은 GPU의 행렬곱 장치를 충분히 활용하지 못할 수 있다. 따라서 “시퀀스 길이에 선형”이라는 점과 “실제 하드웨어에서 빠르다”는 주장은 분리해 봐야 한다.
논문이 제시하는 관점은 같은 변환을 세 가지 방식으로 볼 수 있다는 것이다. recurrent form은 순차 상태 갱신을 보여 주고, quadratic form은 모든 위치 사이의 상호작용을 행렬로 드러내며, matrix form은 둘 사이를 구조적으로 연결한다. 이 연결은 SSM을 단지 새로운 RNN으로 보는 대신, 이미 최적화가 풍부한 어텐션 계산과 같은 문제 공간에 놓는다.
쉬운 정의: 입력을 받을 때마다 내부 상태를 갱신하고, 그 상태에서 출력을 만드는 시퀀스 모델이다.
예시: 메모장에 지금까지의 대화를 한 줄 요약해 두고 다음 문장을 읽을 때 그 요약만 참고하는 방식이다. 요약 규칙과 보관량을 학습할 수 있다는 점이 일반적인 메모와 다르다.
SSD의 핵심: 행렬 구조가 두 계산 경로를 잇는다
논문은 SSM이 특정한 준반분리 행렬로 표현될 수 있음을 보인다. 이 행렬은 모든 위치의 관계를 무작정 저장하지 않는다. 대각선 블록과 낮은 랭크(low-rank) 블록 같은 구조를 이용해 필요한 매개변수와 곱셈을 줄인다. 그 결과 같은 연산을 순차 recurrence로 계산할 수도 있고, 블록 단위 행렬곱으로 계산할 수도 있다.
SSD(State Space Duality)는 이 이중성을 이름 붙인 프레임워크다. 중요한 것은 “어텐션이 SSM과 완전히 동일하다”는 식의 단순화가 아니다. 논문은 모든 어텐션이 아니라, 구조적 행렬로 표현되는 특정한 SSM과 커널·마스킹 변형 사이의 관계를 다룬다고 명시한다. 즉 제목의 직관은 강력하지만 적용 범위는 수학적 조건 안에 있다.
실행 알고리즘은 시퀀스를 청크로 나누어 블록 내부에서는 병렬 행렬 연산을 사용하고, 블록 사이에서는 요약된 recurrent state를 전달하는 방식으로 설명된다. 이 방식은 순차 계산의 상태 의미를 유지하면서도 GPU가 잘하는 큰 행렬곱을 끌어온다. 논문이 말하는 하드웨어 효율성은 바로 이 계산 경로의 선택 가능성에서 나온다.
쉬운 정의: 전체 행렬처럼 보이지만, 위치 사이의 많은 블록이 낮은 랭크의 작은 표현으로 압축되는 구조적 행렬이다.
예시: 도시 전체 도로 지도를 모든 교차로 쌍으로 저장하는 대신, 구역별 요약과 구역 사이 연결 규칙으로 보관하는 것과 비슷하다. 필요한 경로 계산은 가능하지만 저장과 계산량은 줄어든다.
쉬운 정의: 다음 입력을 처리할 때 과거 전체 대신 전달되는 고정 크기의 내부 값이다.
예시: 긴 회의의 모든 녹취 대신 회의록 한 장을 다음 회의에 가져가는 것이다. 회의록이 작을수록 편하지만, 중요한 세부를 잃을 가능성도 함께 관리해야 한다.
Mamba-2에서 바뀐 것은 알고리즘만이 아니다
논문은 SSD 계층과 함께 Mamba 블록의 설계도 조정한다. 데이터 의존적 projection을 블록 시작 부분에서 병렬로 계산하고, 어텐션의 multi-head에서 빌려온 head 구조를 SSM의 선택지로 가져온다. 또한 tensor parallelism을 적용하기 쉽도록 동기화 지점을 줄이는 설계를 설명한다. 긴 시퀀스를 여러 장치에 나누는 sequence parallelism에서는 장치 사이에 recurrent state를 넘기는 방식도 제시한다.
이 부분의 실무적 의미는 새 계층 하나의 FLOPs만 보는 것이 아니라 학습 시스템 전체를 바꿔야 한다는 데 있다. 커널, 통신, 가변 길이 배치, 메모리 레이아웃이 함께 맞아야 실제 지연 시간이 줄어든다. 논문은 variable-length sequence에서 패딩을 피하는 방법도 논의하지만, 각 하드웨어·프레임워크 조합에서 동일한 효과가 재현된다고 보장하지는 않는다.
논문 구조와 근거의 범위
원문은 Introduction에서 Transformer와 SSM의 문제를 제시한 뒤, Background에서 SSM·어텐션·구조적 행렬을 정리한다. 이어 SSM을 행렬로 표현하고, structured masked attention과 SSD의 이론적 관계를 전개한 다음, 효율 알고리즘·Mamba-2 설계·시스템 최적화·실험으로 이동한다. 이는 문제→공통 표현→알고리즘→아키텍처→검증의 흐름이다.
초록과 본문은 SSD 핵심 계층이 Mamba의 선택적 scan보다 2–8배 빠르며 Transformer와 경쟁적인 언어모델링 성능을 보였다고 보고한다. 본문에는 특정 조건에서 FlashAttention-2와의 교차점과 긴 시퀀스 속도 비교, Pile 학습과 downstream 평가, scaling law 및 ablation이 포함된다. 그러나 이 수치는 원문이 설정한 구현·하드웨어·배치·길이 조건의 결과다. 이 글에서는 별도의 벤치마크를 수행하지 않았으므로 “모든 환경에서 2–8배”로 일반화하지 않는다.
실무적으로 무엇이 달라지는가
- 추론 서버: 전체 KV cache 대신 고정 크기 상태를 유지하는 설계는 긴 입력이나 동시 사용자 수가 많은 서비스에서 메모리 계획을 단순화할 가능성이 있다. 다만 상태가 긴 문맥의 모든 정보를 보존한다는 뜻은 아니다.
- 학습 스택: SSD의 chunkwise·block 구조는 GEMM과 tensor parallelism을 활용할 여지를 준다. 실제 도입 전에는 커널 구현과 통신 비용을 함께 프로파일링해야 한다.
- 모델 선택: Mamba-2는 Transformer의 대체품이라는 한 문장보다, recurrent inference와 병렬 학습 사이의 절충점을 제공하는 계층으로 보는 편이 정확하다.
- 평가: perplexity와 downstream 점수 외에 긴 문맥 회수, 상태 크기, batch 크기별 지연·처리량, 메모리 피크를 같은 조건에서 측정해야 한다.
한계와 남은 질문
논문은 SSM과 어텐션의 깊은 연결을 제시하지만, 그 연결이 모든 softmax attention의 동등한 대체를 의미하지는 않는다. 또한 reported speedup은 특정 최적화 구현의 결과이므로 새 GPU, 다른 정밀도, 작은 batch, 실제 serving workload에서 다시 확인해야 한다. recurrent state가 문맥을 압축하는 만큼, 복잡한 임의 회수나 장거리 상호작용에서 어떤 정보 손실 패턴을 보이는지도 애플리케이션별 검증이 필요하다.
제공된 자료에서 확인되는 범위에서 Mamba-2의 가장 중요한 기여는 “선형 복잡도”라는 표어가 아니다. 동일한 시퀀스 변환을 recurrence와 행렬곱 양쪽으로 바라보고, 그 선택을 하드웨어와 분산 학습의 언어로 연결한 점이다. 정량적 성능은 추가 검증이 필요하지만, 연구 방향은 분명하다. 새로운 아키텍처의 승부처는 수식의 우아함과 커널·메모리·통신의 현실을 함께 설명할 수 있는가에 있다.
Sources
- Tri Dao, Albert Gu, “Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality,” arXiv:2405.21060, submitted 2024-05-31, CC BY 4.0. https://arxiv.org/abs/2405.21060
- HTML full text, arXiv:2405.21060v1, sections 1–9, retrieved 2026-08-19. https://arxiv.org/html/2405.21060v1